

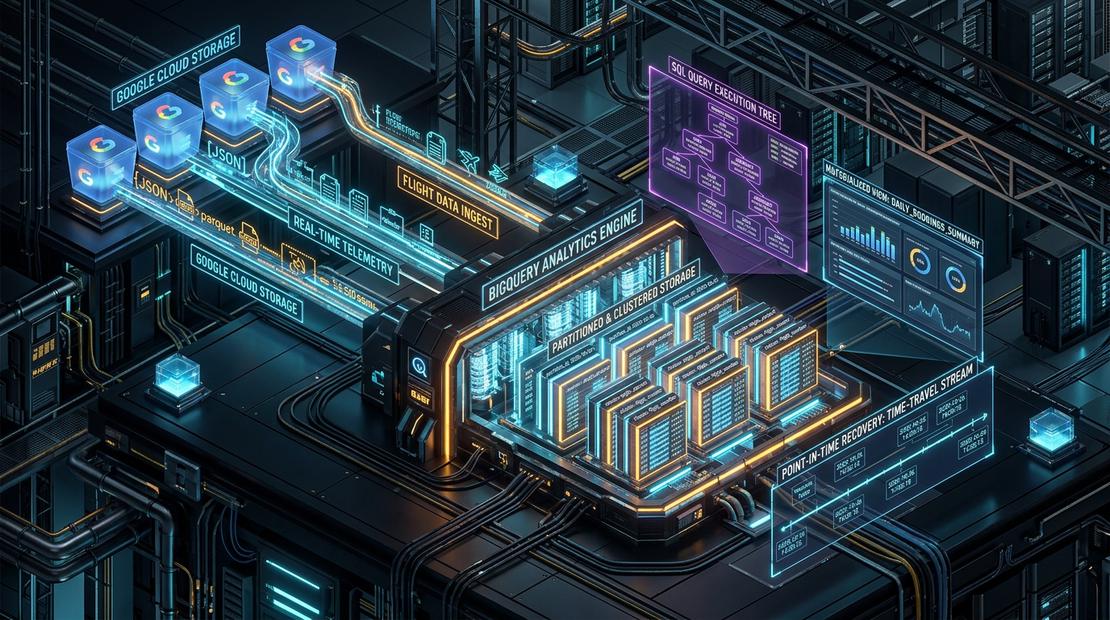
Data Engineering su GCP: Costruire il Layer di Storage e Accesso in Produzione (Lab Pratico)
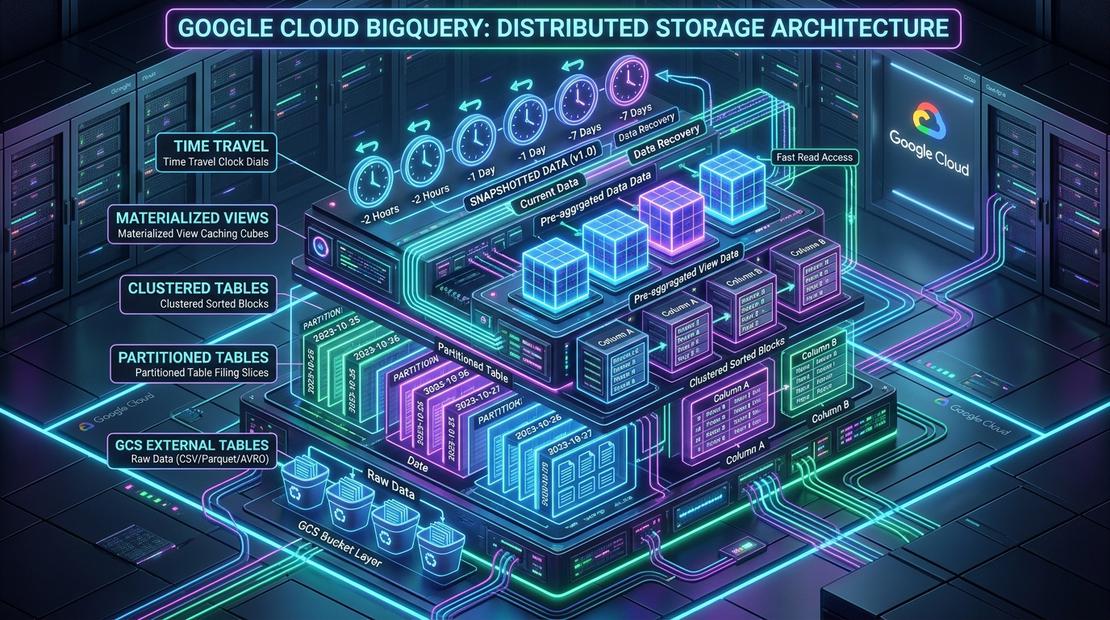
Nella Parte 1 di questa serie, abbiamo tracciato l’evoluzione architetturale di Offvia, un motore di prenotazione voli regionale che ha rapidamente superato i limiti del suo database transazionale. Abbiamo analizzato perché l’analisi dati cloud moderna richiede primitive di storage distinte: dal landing grezzo su Cloud Storage alla potatura colonnare in BigQuery, all’aggregazione automatica nelle Viste Materializzate, fino all’isolamento crittografico nelle Viste Autorizzate.
Ora è il momento di costruirlo.
I diagrammi architetturali sono utili, ma nascondono i dettagli operativi che contano davvero alle 3:00 di notte in produzione. Il vero lavoro ingegneristico inizia quando devi scrivere il DDL, scegliere i confini delle partizioni, gestire gli eventi in ritardo attraverso offset di fuso orario, recuperare da un UPDATE accidentale in produzione, o esporre metriche utili agli auditor senza far trapelare un singolo byte di dati dei passeggeri.
In questo lab, costruiremo il layer di storage e accesso di Offvia da zero usando Google Cloud CLI (gcloud), il CLI bq, BigQuery SQL e Python. L’obiettivo non è solo creare risorse, ma capire perché ogni scelta progettuale è importante e cosa succede quando le cose vanno storte.
Ambiente Lab e Prerequisiti: Tutti i comandi in questa guida usano strumenti Google Cloud standard: gcloud CLI (v480.0+), bq CLI, Python 3.10+ e SQL BigQuery standard. Assicurati di avere i ruoli IAM roles/bigquery.admin e roles/storage.admin assegnati. Sostituisci offvia-prod-data con il tuo ID progetto. Le funzionalità di riscrittura delle viste materializzate e le funzioni enterprise presuppongono le edizioni BigQuery Enterprise/Enterprise Plus o il pricing On-Demand standard.
require_partition_filter.5 Comuni Misconcezioni nel Data Engineering su GCP
Prima di eseguire qualsiasi comando, chiarifichiamo cinque comuni misconcezioni che portano frequentemente a costi di query inattesi, prestazioni scarse o fallimenti di audit.
Il Mito: "Se archiviamo i dati di prenotazione in Apache Parquet su Cloud Storage, le query sulle tabelle esterne avranno le stesse prestazioni delle tabelle native BigQuery."
La Realtà: Le query esterne devono effettuare chiamate HTTP remote a Cloud Storage, elencare i metadati degli oggetti e leggere i file sulla rete senza la compressione nativa Capacitor, la potatura del dizionario min/max a livello di blocco o il throughput diretto NVMe del bus Colossus.
Il Mito: "Basta clusterizzare per data di prenotazione e codice vettore; il clustering è più flessibile del partizionamento rigido."
La Realtà: Il partizionamento garantisce la potatura dei costi prima che l'esecuzione della query inizi e consente l'enforcement tramite require_partition_filter = true. Il clustering ottimizza il layout dei blocchi all'interno delle partizioni. Se ometti il partizionamento, una query fuori controllo può scansionare l'intero dataset storico pluriennale.
Il Mito: "Crea viste materializzate su tutte le query pesanti delle dashboard per rendere tutto istantaneo."
La Realtà: Se una query contiene funzioni non deterministiche (come CURRENT_TIMESTAMP()), funzioni finestra senza aggregazioni, o colonne group-by ad alta cardinalità, BigQuery non può riscrivere la query in modo trasparente e la vista aggiunge overhead di manutenzione degli slot senza alcun beneficio in termini di velocità.
Il Mito: "Non abbiamo bisogno di snapshot di disaster recovery perché BigQuery ha il Time Travel integrato a 7 giorni."
La Realtà: Il Time Travel fornisce solo una finestra scorrevole di 7 giorni (configurabile da 2 a 7 giorni). Se una corruzione silenziosa dei dati o un bug nella logica DML va inosservato per 8 giorni, il Time Travel non può aiutarti. La vera protezione point-in-time di base richiede Table Snapshot espliciti.
Il Mito: "Concedere a un utente roles/bigquery.dataViewer su una vista lo autorizza automaticamente a interrogare la tabella sottostante."
La Realtà: Se non si autorizza esplicitamente la vista nella configurazione del dataset sorgente, BigQuery controlla i permessi sulla tabella sottostante e restituisce immediatamente 403 Access Denied. Inoltre, l'utente esterno ha ancora bisogno di roles/bigquery.jobUser sul proprio progetto per allocare gli slot di query.
La Pipeline End-to-End
Prima di eseguire i comandi, esaminiamo la topologia della pipeline che stiamo costruendo:
  [Producers: Booking Web App / Kiosk Sync / Offline Flight Batch]
                              │
                              ▼
        ┌──────────────────────────────────────────────┐
        │  Cloud Storage Landing Bucket (Raw Lake)     │
        │  gs://offvia-raw-lake/bookings/year=.../     │
        └──────────────────────┬───────────────────────┘
                               │
            ┌──────────────────┴──────────────────┐
            ▼                                     ▼
   ┌───────────────────────┐             ┌───────────────────────────┐
   │ BigLake Connection    │             │ Managed Table Ingestion   │
   │ (Secure Staging GCS)  │             │ PARTITION BY DATE()       │
   │ offvia_staging        │             │ CLUSTER BY carrier, route │
   └───────────────────────┘             │ offvia_warehouse          │
                                         └─────────────┬─────────────js
                                                       │
                 ┌─────────────────────────────────────┴─────────────────────────────────────┐
                 ▼                                                                           ▼
   ┌───────────────────────────────┐                                           ┌───────────────────────────────┐
   │ Materialized View             │                                           │ Authorized View               │
   │ (Transparent Query Rewrite)   │                                           │ (PII Masking & Delegation)    │
   │ offvia_analytics              │                                           │ offvia_compliance             │
   └──────────────┬────────────────┘                                           └──────────────┬────────────────┘
                  │                                                                           │
                  ▼                                                                           ▼
     [Live Operational Dashboards]                                                [Aviation Regulatory Auditors]
     (Sub-second response, 0 slot storms)                                         (Aggregates only, zero PII)
Setup del Lab: Ambiente e Topologia GCP
Apri il tuo terminale o Google Cloud Shell. Definiamo la configurazione del progetto e configuriamo quattro dataset BigQuery isolati che rappresentano i nostri layer di architettura a medaglione:
# 1. Esporta le variabili di ambiente del deployment
export PROJECT_ID="offvia-prod-data"
export REGION="europe-west1"
export BUCKET_NAME="offvia-raw-lake-${PROJECT_ID}"
export CONNECTION_ID="gcs-secure-conn"

# Imposta il progetto attivo
gcloud config set project ${PROJECT_ID}

# 2. Abilita le API Google Cloud richieste
gcloud services enable \
    storage.googleapis.com \
    bigquery.googleapis.com \
    bigqueryconnection.googleapis.com

# 3. Crea i 4 dataset architetturali in BigQuery
bq --location=${REGION} mk -d \
    --description "Staging and raw external table bindings" \
    ${PROJECT_ID}:offvia_staging

bq --location=${REGION} mk -d \
    --description "Core immutable partitioned & clustered warehouse fact tables" \
    ${PROJECT_ID}:offvia_warehouse

bq --location=${REGION} mk -d \
    --description "Precomputed materialized views and operational analytics" \
    ${PROJECT_ID}:offvia_analytics

bq --location=${REGION} mk -d \
    --description "Governed authorized views for external auditors and compliance" \
    ${PROJECT_ID}:offvia_compliance
Step 1: Landing Grezzo su Cloud Storage con Partizionamento Hive
Un pattern utile per le piattaforme dati di produzione è mantenere il layer di landing grezzo separato dai dati trasformati. Se un modello downstream o una modifica dello schema si rivela errata, i file originali rimangono disponibili per la riproduzione.
1.1 Crea il Bucket Cloud Storage Dual-Region
Usiamo l’accesso uniforme a livello di bucket affinché i permessi siano gestiti in modo coerente a livello di bucket:
gcloud storage buckets create gs://${BUCKET_NAME} \
    --project=${PROJECT_ID} \
    --location=${REGION} \
    --uniform-bucket-level-access
1.2 Genera Dati di Prenotazione Simulati (Python SDK)
Per mantenere il lab riproducibile, generiamo 45.000 record di prenotazione sintetici su tre giorni. I dati usano un piccolo set di vettori, rotte europee, stati di prenotazione e classi di seduta in modo che le query risultanti siano facili da esaminare.
Crea un ambiente virtuale, installa le dipendenze e salva questo script come generate_bookings.py:
python3 -m venv venv
source venv/bin/activate
pip install pandas pyarrow
import datetime
import os
import random
import uuid
import pandas as pd
import pyarrow as pa
import pyarrow.parquet as pq

# Seed per riproducibilità
random.seed(42)

CARRIERS = ["LH", "BA", "AF", "FR", "U2"]
ROUTES = ["FRA_LHR", "CDG_BER", "AMS_MAD", "FCO_BCN", "MUC_CDG", "LHR_DUB"]
SEAT_CLASSES = ["ECONOMY", "ECONOMY", "ECONOMY", "PREMIUM_ECONOMY", "BUSINESS"]
STATUSES = ["CONFIRMED", "CONFIRMED", "CONFIRMED", "CANCELLED", "MODIFIED"]

def generate_flight_records(date_str: str, num_records: int = 15000):
    base_date = datetime.datetime.strptime(date_str, "%Y-%m-%d")
    records = []
    for _ in range(num_records):
        minute_offset = random.randint(0, 1439)
        second_offset = random.randint(0, 59)
        event_time = base_date + datetime.timedelta(minutes=minute_offset, seconds=second_offset)
        # Flight fares in Euro cents (e.g. 149.50 EUR = 14950 cents)
        fare_cents = random.randint(4500, 75000)
        carrier = random.choice(CARRIERS)
        route = random.choice(ROUTES)
        booking_id = str(uuid.uuid4())
        passenger_id = f"PAX_{random.randint(10000, 99999)}"
        passenger_email = f"user_{random.randint(100, 999)}@example-travel.com"
        records.append({
            "booking_id": booking_id,
            "flight_id": f"{carrier}-{random.randint(100, 999)}",
            "carrier_code": carrier,
            "route_id": route,
            "passenger_id": passenger_id,
            "passenger_email": passenger_email,
            "event_time": event_time,
            "fare_amount_cents": fare_cents,
            "currency": "EUR",
            "seat_class": random.choice(SEAT_CLASSES),
            "status": random.choice(STATUSES),
        })
    return pd.DataFrame(records)

# Genera 3 giorni di dati di prenotazione
dates = ["2026-09-28", "2026-09-29", "2026-09-30"]
for d in dates:
    df_day = generate_flight_records(d, num_records=15000)
    year, month, day = d.split("-")
    # Percorso partizione Hive standard
    dir_path = f"raw_data/year={year}/month={month}/day={day}"
    os.makedirs(dir_path, exist_ok=True)
    file_path = os.path.join(dir_path, "bookings_batch_001.parquet")
    table = pa.Table.from_pandas(df_day)
    pq.write_table(table, file_path, compression="SNAPPY")
    print(f"Generati {len(df_day)} record in {file_path}")
Esegui lo script e carica i file con partizione Hive direttamente su Cloud Storage:
python3 generate_bookings.py

# Sincronizza nel bucket Cloud Storage con upload parallelo
gcloud storage rsync -r raw_data/ gs://${BUCKET_NAME}/bookings/
Verifica che i file siano atterrati con la corretta gerarchia di cartelle:
gcloud storage ls --recursive gs://${BUCKET_NAME}/bookings/
Output:
gs://offvia-raw-lake-offvia-prod-data/bookings/year=2026/month=09/day=28/bookings_batch_001.parquet
gs://offvia-raw-lake-offvia-prod-data/bookings/year=2026/month=09/day=29/bookings_batch_001.parquet
gs://offvia-raw-lake-offvia-prod-data/bookings/year=2026/month=09/day=30/bookings_batch_001.parquet
Step 2: Creazione e Profilazione delle Tabelle Esterne BigLake
Per interrogare i file in modo sicuro dove sono atterrati senza copiare i dati nello storage nativo, stabiliamo una connessione BigLake. BigLake abilita il controllo degli accessi granulare fino al livello di oggetto e file.
2.1 Crea la Connessione alla Risorsa Cloud
bq mk --connection \
    --location=${REGION} \
    --connection_type=CLOUD_RESOURCE \
    ${CONNECTION_ID}

# Recupera e concedi i permessi del service account della connessione sul bucket
CONNECTION_SA=$(bq show --connection ${PROJECT_ID}.${REGION}.${CONNECTION_ID} | grep 'serviceAccountId' | awk -F'"' '{print $4}')

gcloud storage buckets add-iam-policy-binding gs://${BUCKET_NAME} \
    --member="serviceAccount:${CONNECTION_SA}" \
    --role="roles/storage.objectViewer"
2.2 Definisci il DDL della Tabella Esterna BigLake
Mappiamo i nomi delle directory (year, month, day) direttamente a colonne virtuali interrogabili usando la connessione sicura:
CREATE OR REPLACE EXTERNAL TABLE offvia_staging.ext_bookings
WITH CONNECTION `offvia-prod-data.europe-west1.gcs-secure-conn`
OPTIONS (
  format = 'PARQUET',
  uris = ['gs://offvia-raw-lake-offvia-prod-data/bookings/*'],
  hive_partition_uri_prefix = 'gs://offvia-raw-lake-offvia-prod-data/bookings/'
);
Esegui tramite CLI:
bq query --use_legacy_sql=false "
CREATE OR REPLACE EXTERNAL TABLE offvia_staging.ext_bookings
WITH CONNECTION \`${PROJECT_ID}.${REGION}.${CONNECTION_ID}\`
OPTIONS (
  format = 'PARQUET',
  uris = ['gs://${BUCKET_NAME}/bookings/*'],
  hive_partition_uri_prefix = 'gs://${BUCKET_NAME}/bookings/'
);"
2.3 Profilazione delle Prestazioni delle Query su Tabelle Esterne
Esegui una query analitica sulla tabella esterna:
SELECT
  carrier_code,
  COUNT(1) AS booking_count,
  ROUND(SUM(fare_amount_cents) / 100.0, 2) AS total_revenue_eur
FROM offvia_staging.ext_bookings
WHERE year = 2026 AND month = 9 AND day = 30
GROUP BY carrier_code
ORDER BY total_revenue_eur DESC;
Analisi dell’Esecuzione: Il Costo delle Tabelle Esterne
Quando si interroga una tabella esterna:
- Metadata Latency: BigQuery workers issue Cloud Storage API calls to discover Parquet files matching the Hive partition prefix, adding baseline overhead (600ms–1500ms).
- Network Read Overhead: Parquet file footers must be pulled across the data center network into the worker slot pool.
- No Result Caching: External table queries cannot guarantee immutability, disabling deterministic cached results.
Step 3: Tabella Gestita di Produzione (Partizionamento e Clustering)
Per i workload analitici primari, migriamo i dati in una tabella BigQuery nativa per sfruttare lo storage Capacitor, i filtri di partizione rigidi e l’ordinamento dei cluster.
3.1 DDL della Tabella Fact di Produzione
CREATE OR REPLACE TABLE offvia_warehouse.fct_bookings (
  booking_id STRING NOT NULL OPTIONS(description="Unique UUIDv4 identifier for the booking"),
  flight_id STRING NOT NULL OPTIONS(description="IATA flight number, e.g. LH-402"),
  carrier_code STRING NOT NULL OPTIONS(description="Operating airline code: LH, BA, AF, FR, U2"),
  route_id STRING NOT NULL OPTIONS(description="Route origin and destination, e.g. FRA_LHR"),
  passenger_id STRING NOT NULL OPTIONS(description="Pseudonymized passenger identity token"),
  passenger_email STRING NOT NULL OPTIONS(description="Customer email address (Restricted PII)"),
  event_time TIMESTAMP NOT NULL OPTIONS(description="UTC timestamp when the booking was transacted"),
  ingestion_time TIMESTAMP NOT NULL OPTIONS(description="UTC timestamp when the record landed in the warehouse"),
  fare_amount_cents INT64 NOT NULL OPTIONS(description="Total fare paid in Euro cents"),
  currency STRING(3) NOT NULL OPTIONS(description="ISO-4217 3-letter currency code"),
  seat_class STRING NOT NULL OPTIONS(description="Cabin class: ECONOMY, PREMIUM_ECONOMY, BUSINESS"),
  status STRING NOT NULL OPTIONS(description="Status: CONFIRMED, MODIFIED, CANCELLED")
)
PARTITION BY DATE(event_time)
CLUSTER BY carrier_code, route_id, status
OPTIONS (
  require_partition_filter = true,
  partition_expiration_days = 1095, -- 3 anni di retention automatica
  description = "Production flight booking fact table for Offvia travel platform"
);
Esegui questo DDL:
bq query --use_legacy_sql=false "
CREATE OR REPLACE TABLE ${PROJECT_ID}:offvia_warehouse.fct_bookings (
  booking_id STRING NOT NULL,
  flight_id STRING NOT NULL,
  carrier_code STRING NOT NULL,
  route_id STRING NOT NULL,
  passenger_id STRING NOT NULL,
  passenger_email STRING NOT NULL,
  event_time TIMESTAMP NOT NULL,
  ingestion_time TIMESTAMP NOT NULL,
  fare_amount_cents INT64 NOT NULL,
  currency STRING NOT NULL,
  seat_class STRING NOT NULL,
  status STRING NOT NULL
)
PARTITION BY DATE(event_time)
CLUSTER BY carrier_code, route_id, status
OPTIONS (
  require_partition_filter = true,
  partition_expiration_days = 1095
);"
3.2 Ingestione dallo Staging nella Tabella Fact Gestita
bq query --use_legacy_sql=false "
INSERT INTO ${PROJECT_ID}:offvia_warehouse.fct_bookings
SELECT
  booking_id,
  flight_id,
  carrier_code,
  route_id,
  passenger_id,
  passenger_email,
  event_time,
  CURRENT_TIMESTAMP() AS ingestion_time,
  fare_amount_cents,
  currency,
  seat_class,
  status
FROM ${PROJECT_ID}:offvia_staging.ext_bookings;"
3.3 Verifica del Partition Pruning e dei Guardrail di Clustering
Test del guardrail require_partition_filter omettendo deliberatamente il filtro per data:
-- Questa query fallirà intenzionalmente
SELECT COUNT(1) FROM offvia_warehouse.fct_bookings WHERE carrier_code = 'LH';
BigQuery interrompe immediatamente l’esecuzione:
Error: Cannot query over table 'offvia-prod-data.offvia_warehouse.fct_bookings'
without a filter over column(s) 'event_time' that can be used for partition elimination.
Ora, esegui la query con i limiti di partizione corretti:
SELECT
  carrier_code,
  route_id,
  COUNT(1) AS flights_booked,
  ROUND(SUM(fare_amount_cents) / 100.0, 2) AS route_revenue_eur
FROM offvia_warehouse.fct_bookings
WHERE event_time >= TIMESTAMP('2026-09-30 00:00:00')
  AND event_time < TIMESTAMP('2026-10-01 00:00:00')
  AND carrier_code = 'LH'
GROUP BY carrier_code, route_id
ORDER BY route_revenue_eur DESC;
Step 4: Dati in Ritardo con Watermark a Doppio Timestamp
Nei sistemi aeronautici reali, l’event time e l’ingestion time divergono. Ad esempio, un acquisto Wi-Fi in volo effettuato a 35.000 piedi sopra l’Atlantico rimane nelle code avioniche finché l’aeromobile non attracca e sincronizza la sua telemetria ore dopo.
4.1 Il Pattern MERGE Idempotente con Scope di Partizione
Per evitare scansioni dell’intera tabella durante l’elaborazione dei record in ritardo, vincola sempre le condizioni del MERGE ai predicati della partizione target:
MERGE INTO offvia_warehouse.fct_bookings AS target
USING (
  SELECT
    '00000000-0000-0000-0000-000000000999' AS booking_id,
    'LH-882' AS flight_id,
    'LH' AS carrier_code,
    'FRA_LHR' AS route_id,
    'PAX_99999' AS passenger_id,
    'vip_pax@example-travel.com' AS passenger_email,
    TIMESTAMP('2026-09-28 14:15:00') AS event_time,
    89000 AS fare_amount_cents,
    'EUR' AS currency,
    'FIRST' AS seat_class,
    'MODIFIED' AS status
) AS source
-- OTTIMIZZAZIONE CRITICA: Vincolare target.event_time forza BigQuery
-- a scansionare SOLO la partizione 2026-09-28 invece dell'intera tabella!
ON target.event_time >= TIMESTAMP('2026-09-28 00:00:00')
   AND target.event_time < TIMESTAMP('2026-09-29 00:00:00')
   AND target.booking_id = source.booking_id
WHEN MATCHED THEN
  UPDATE SET
    status = source.status,
    seat_class = source.seat_class,
    fare_amount_cents = source.fare_amount_cents,
    ingestion_time = CURRENT_TIMESTAMP()
WHEN NOT MATCHED THEN
  INSERT (
    booking_id, flight_id, carrier_code, route_id, passenger_id, passenger_email,
    event_time, ingestion_time, fare_amount_cents, currency, seat_class, status
  )
  VALUES (
    source.booking_id, source.flight_id, source.carrier_code, source.route_id, source.passenger_id, source.passenger_email,
    source.event_time, CURRENT_TIMESTAMP(), source.fare_amount_cents, source.currency, source.seat_class, source.status
  );
Step 5: Viste Materializzate e Riscrittura Trasparente delle Query
Le viste materializzate precomputano i riepiloghi giornalieri, consentendo alle dashboard di funzionare senza lag mentre si mantengono automaticamente sincronizzate con gli aggiornamenti della tabella base.
5.1 Crea il DDL della Vista Materializzata
CREATE MATERIALIZED VIEW offvia_analytics.mv_carrier_daily_summary
OPTIONS (
  enable_refresh = true,
  refresh_interval_minutes = 30
)
AS
SELECT
  DATE(event_time) AS booking_date,
  carrier_code,
  route_id,
  seat_class,
  COUNT(1) AS total_bookings,
  SUM(fare_amount_cents) AS total_revenue_cents,
  AVG(fare_amount_cents) AS avg_fare_cents
FROM offvia_warehouse.fct_bookings
GROUP BY 1, 2, 3, 4;
5.2 Validazione della Riscrittura Trasparente delle Query
Quando gli analisti eseguono query standard sulla tabella base fct_bookings:
SELECT
  carrier_code,
  SUM(fare_amount_cents) / 100.0 AS total_revenue_eur
FROM offvia_warehouse.fct_bookings
WHERE event_time >= TIMESTAMP('2026-09-30 00:00:00')
  AND event_time < TIMESTAMP('2026-10-01 00:00:00')
GROUP BY carrier_code;
Il Cost-Based Optimizer (CBO) ispeziona il grafico di esecuzione e reindirizza in modo trasparente l’I/O per leggere esclusivamente da mv_carrier_daily_summary, riducendo i byte scansionati di oltre il 99%.
Step 6: Esercitazione di Disaster Recovery: Ripristino Point-in-Time con Time Travel
6.1 Simulazione del Disastro
Un ingegnere esegue accidentalmente un’operazione DML distruttiva senza un predicato appropriato:
UPDATE ${PROJECT_ID}:offvia_warehouse.fct_bookings
SET status = 'CANCELLED'
WHERE DATE(event_time) = '2026-09-30';
6.2 Il Runbook di Recupero con Time Travel
Usando la finestra Time Travel integrata a 7 giorni di BigQuery (FOR SYSTEM_TIME AS OF), ispezioniamo e recuperiamo lo stato della tabella di 5 minuti prima:
-- 1. Crea uno snapshot di recupero temporaneo
CREATE OR REPLACE TABLE offvia_warehouse.fct_bookings_recovery_snapshot AS
SELECT *
FROM offvia_warehouse.fct_bookings
FOR SYSTEM_TIME AS OF TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 5 MINUTE)
WHERE DATE(event_time) = '2026-09-30';

-- 2. Merge con scope di partizione di ritorno alla tabella principale
MERGE INTO offvia_warehouse.fct_bookings AS target
USING offvia_warehouse.fct_bookings_recovery_snapshot AS source
ON target.event_time >= TIMESTAMP('2026-09-30 00:00:00')
   AND target.event_time < TIMESTAMP('2026-10-01 00:00:00')
   AND target.booking_id = source.booking_id
WHEN MATCHED THEN
  UPDATE SET
    status = source.status,
    seat_class = source.seat_class,
    fare_amount_cents = source.fare_amount_cents;

-- 3. Pulizia snapshot
DROP TABLE offvia_warehouse.fct_bookings_recovery_snapshot;
Step 7: Viste Autorizzate e Mascheramento PII Zero-Trust
Le autorità aeronautiche europee richiedono informazioni sui volumi delle rotte, ma esporre colonne grezze come passenger_email o passenger_id viola la conformità GDPR e PCI-DSS.
7.1 Crea il DDL della Vista di Compliance
CREATE OR REPLACE VIEW offvia_compliance.v_audited_flight_metrics
OPTIONS(
  description="Audited aggregated route capacity metrics for regulatory compliance. PII stripped."
)
AS
SELECT
  DATE(event_time) AS flight_date,
  carrier_code,
  route_id,
  seat_class,
  COUNT(DISTINCT booking_id) AS total_passenger_count,
  ROUND(SUM(fare_amount_cents) / 100.0, 2) AS total_gross_fare_eur,
  ROUND(AVG(fare_amount_cents) / 100.0, 2) AS average_fare_eur
FROM offvia_warehouse.fct_bookings
WHERE status = 'CONFIRMED'
GROUP BY 1, 2, 3, 4;
7.2 Autorizza la Vista nel Dataset Sorgente
bq update --dataset --add_view \
    ${PROJECT_ID}:offvia_compliance.v_audited_flight_metrics \
    ${PROJECT_ID}:offvia_warehouse
Questa delega crittografica consente ai ruoli di revisori esterni di interrogare metriche aggregate attraverso la vista, ricevendo un immediato 403 Access Denied se tentano di interrogare direttamente la tabella base sottostante.
Cheat Sheet di Produzione: Storage e Accesso GCP
| Primitiva | DDL / Sintassi Chiave | Scopo Principale | Impatto su Costi / Slot |
|---|---|---|---|
| Tabella BigLake | CREATE EXTERNAL TABLE ... WITH CONNECTION | Esplorazione SQL sicura zero-copy su file Cloud Storage | Alta latenza di scansione; nessun caching; zero costo storage in BigQuery |
| Tabella Partizionata | PARTITION BY DATE(col) OPTIONS(require_partition_filter=true) | Potatura grossolana delle date storiche; elimina scansioni incontrollate | Scansiona solo i blocchi di date interrogate; garantisce costo query prevedibile |
| Tabella Clusterizzata | CLUSTER BY col1, col2, col3 | Ordinamento blocchi fine-grained nelle partizioni; ottimale per filtri di uguaglianza | Zero costo storage extra; ri-clustering automatico in background |
| Vista Materializzata | CREATE MATERIALIZED VIEW ... AS SELECT ... GROUP BY | Accelerazione trasparente per dashboard BI ad alta concorrenza | Riduce drasticamente il consumo di slot; manutenzione refresh incrementale |
| Time Travel | FOR SYSTEM_TIME AS OF TIMESTAMP_SUB(..., INTERVAL X MINUTE) | Disaster recovery istantaneo da DML accidentale senza ripristino di backup | Fatturato nella cronologia fisica a 7 giorni; zero configurazione richiesta |
| Vista Autorizzata | CREATE VIEW ... + bq update --dataset --add_view | Delega crittografica dei dati; espone aggregati senza PII della tabella base | Accesso alla tabella base completamente schermato; zero rischio di perdita PII |
Documentazione Ufficiale Google Cloud
- Architettura Storage BigQuery di Google Cloud (Colossus e Capacitor)
- Gestione delle Tabelle Partizionate in BigQuery
- Clustering nelle Tabelle BigQuery
- Best Practice per le Viste Materializzate BigQuery
- Time Travel e Storage Fail-Safe in BigQuery
- Creazione e Utilizzo delle Viste Autorizzate
- Tabelle BigLake e Object Storage Esterno
Community Discussion 0