

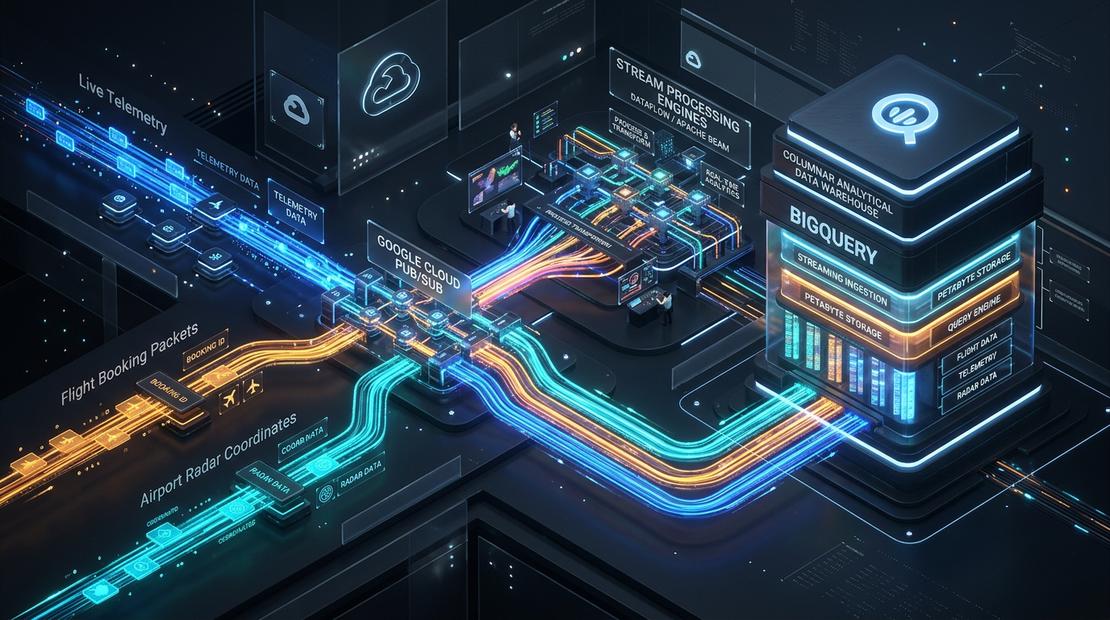
Nella Parte 3 e nella Parte 4, abbiamo costruito il percorso di streaming ingestion per Offvia. Gli eventi di prenotazione, le cancellazioni e gli aggiornamenti dei posti arrivano ora continuamente su BigQuery e Cloud Storage.
Questo è un ottimo punto di partenza, ma non è il traguardo finale.
Lunedì mattina, una dashboard per il management riporta un fatturato lordo negativo per la domenica. Afferma inoltre che il volo OF-302 ha trasportato 400 passeggeri su un Airbus A320 da 180 posti. La pipeline di streaming funziona alla perfezione. I dati no.
Non è accaduto nulla di “misterioso” nell’ingestion. Il sistema ha accettato esattamente ciò che era progettato per accettare: record grezzi da producer distribuiti. Durante una vendita promozionale lampo, Offvia ha sperimentato retry duplicati, payload di rimborso malformati e una fragile stored procedure notturna che tentava un ricalcolo completo (full rebuild). Il risultato è stato un fallimento costoso e una reportistica del tutto inaffidabile.
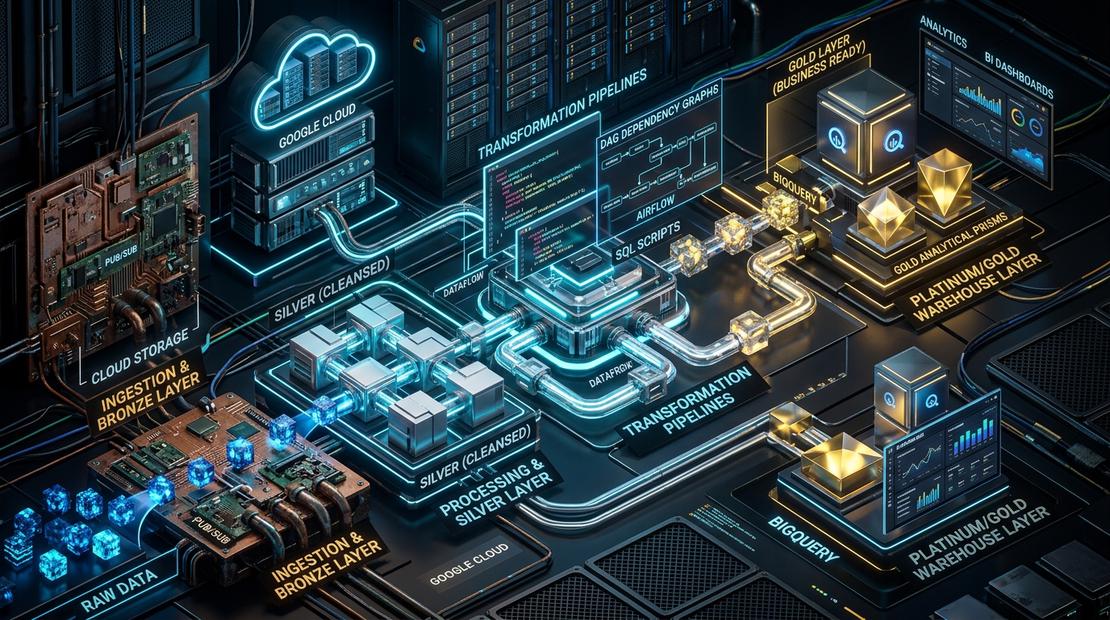
Questo articolo spiega come trasformare i dati grezzi di landing su BigQuery in analisi affidabili con un layer di trasformazione Medallion:
- Bronze per eventi grezzi immutabili
- Silver per dati tipizzati, deduplicati e conformati
- Gold per data mart pronti per il business
- Dataform o dbt per flussi di lavoro SQL basati su grafi di dipendenza
- Elaborazione incrementale capace di gestire i dati in ritardo senza dover scansionare ripetutamente l’intera cronologia
- Controlli di qualità e percorsi di quarantena che impediscono a metriche errate di raggiungere le dashboard
Distinzione importante: Dataform e dbt orchestrano e generano SQL per il data warehouse. Per i modelli BigQuery, il calcolo effettivo della trasformazione viene eseguito all’interno di BigQuery, non in Dataform o dbt. Dataform compila il codice del workflow, risolve le dipendenze ed esegue le azioni risultanti in BigQuery. Panoramica di Dataform
L’Analogia del Ristorante
Un ristorante ad alto volume non serve i piatti direttamente dalla banchina di scarico delle merci.
[Banchina di carico]  ──>  [Postazione di prep]  ──>  [Pass caldo]  ──>  [Sala ristorante]
       Bronze                     Silver                  Gold             Consumatori
- Bronze — banchina di carico: Preserva ciò che è arrivato. I record possono essere duplicati, malformati, in ritardo o non ancora interpretati.
- Silver — postazione di preparazione: Esegue il parsing, il cast, la validazione, la deduplicazione, la standardizzazione di nomi e codici, isolando le eccezioni.
- Gold — pass caldo: Consegna tabelle modellate per consumatori specifici: finanza, operation, supporto clienti o Business Intelligence.
Il valore non risiede nelle etichette Bronze, Silver e Gold in sé, ma nel contratto rigoroso stabilito tra i livelli: i dati grezzi restano recuperabili, i dati conformati diventano riutilizzabili e i dati di business diventano sicuri da consumare.
Regola aurea: Non collegare mai le dashboard aziendali direttamente alle tabelle di ingestion grezze. I dati grezzi costituiscono evidenze storiche, non un contratto di reportistica.
L’Architettura
┌──────────────────────────────────────────────────────────────────────┐
│ BRONZE: offvia_bronze                                                 │
│ Record immutabili append-only; JSON grezzo; metadati di arrivo       │
└───────────────────────────────┬──────────────────────────────────────┘
                                │
                                ▼
┌──────────────────────────────────────────────────────────────────────┐
│ PIANO DI CONTROLLO DELLE TRASFORMAZIONI                               │
│ Dataform o dbt: Git, grafo dipendenze, compilazione SQL, test, run    │
└───────────────────────────────┬──────────────────────────────────────┘
                                │
                                ▼
┌──────────────────────────────────────────────────────────────────────┐
│ SILVER: offvia_silver                                                 │
│ Entità ed eventi tipizzati, deduplicati e validati                   │
│ Più: offvia_quarantine per righe che richiedono investigazione      │
└───────────────────────────────┬──────────────────────────────────────┘
                                │
                                ▼
┌──────────────────────────────────────────────────────────────────────┐
│ GOLD: offvia_gold                                                     │
│ Fatti, dimensioni, aggregati, contratti semantici di reportistica    │
└───────────────────────────────┬──────────────────────────────────────┘
                                │
                                ▼
┌──────────────────────────────────────────────────────────────────────┐
│ CONSUMO                                                               │
│ Looker / Looker Studio / BI Engine / analisi ad-hoc / reverse ETL    │
└──────────────────────────────────────────────────────────────────────┘
Un’implementazione solida stabilisce confini operativi chiari:
- Service account e permessi sui dataset separati per ambiente (dev, staging, prod).
- SQL versionato sotto Git e revisionato tramite Pull Request.
- Un processo ripetibile per ricaricamenti completi (full refresh) e backfill.
- Osservabilità su freschezza dei dati, volumi, fallimenti dei test di qualità e costi di BigQuery.
- Una destinazione di quarantena con un referente (data owner) esplicito per la bonifica.
Dataform, dbt o Stored Procedure?
Le stored procedure rimangono utili per una quantità circoscritta di attività procedurali: operazioni amministrative, transazioni strettamente delimitate o manutenzioni eccezionali del warehouse. Non sono di per sé sbagliate. Il problema nasce quando si impiega un’unica gigantesca stored procedure come intera piattaforma di trasformazione.
Dataform e dbt permettono invece di definire singoli asset di dati e le loro reciproche relazioni. Una chiamata come ${ref("stg_bookings")} in Dataform o {{ ref("stg_bookings") }} in dbt dichiara una dipendenza esplicita. Il framework costruisce il grafo aciclico diretto (DAG), esegue per primi i modelli a monte e traccia la derivazione (lineage).
| Dimensione | Stored Procedure BigQuery | Google Cloud Dataform | dbt Core / dbt Cloud |
|---|---|---|---|
| Stile principale | Scripting SQL imperativo | SQLX più JavaScript opzionale | SQL più template Jinja |
| Grafo delle dipendenze | Manuale o tramite orchestratore esterno | Grafo nativo tramite ref() | Grafo nativo tramite ref() |
| Runtime di trasformazione | BigQuery | BigQuery | Il tuo data warehouse (ad es. BigQuery) |
| Servizio gestito | Solo BigQuery | Servizio completamente gestito su GCP | Core richiede un runner; Cloud è SaaS gestito |
| Test di qualità dati | Query SQL manuali | Asserzioni integrate e personalizzate | Test YAML e test personalizzati |
| Portabilità | Specifico per BigQuery | Focalizzato su BigQuery | Ampio ecosistema di adapter multi-piattaforma |
| Scenario ideale | Attività procedurali mirate | Team BigQuery-first che cercano minima complessità infrastrutturale | Architetture multi-cloud o team con convenzioni dbt consolidate |
Cosa fa concretamente Dataform
Dataform utilizza SQLX e file di configurazione per definire tabelle, viste, tabelle incrementali, asserzioni, dipendenze, documentazione e operazioni di workflow. Compila queste definizioni in SQL per BigQuery, risolve dipendenze mancanti o circolari, costruisce il DAG ed esegue le relative azioni in BigQuery. Si integra nativamente con Git e consente di pianificare le esecuzioni tramite configurazioni di workflow. Panoramica di Dataform
Una precisazione fondamentale: la fase di compilazione non garantisce che ogni colonna o tipo di dati referenziato in BigQuery sia già stato convalidato tramite un dry run gratuito del warehouse. Considera la compilazione di Dataform come una validazione di codice e di grafo delle dipendenze. Convalida la semantica e i costi separatamente tramite validazione query di BigQuery, verifiche in CI/CD, esecuzioni controllate e dati di test realistici.
Una decisione pragmatica
Scegli Dataform quando il tuo data warehouse è BigQuery, desideri l’integrazione nativa con Cloud IAM e la console GCP, e punti a ridurre al minimo i componenti mobili dell’infrastruttura.
Scegli dbt se la portabilità multi-piattaforma, l’ecosistema di package (come dbt-utils o dbt-expectations), pratiche standardizzate di analytics engineering o una piattaforma dbt esistente sono prioritari. Su BigQuery, dbt supporta strategie incrementali come merge e insert_overwrite: seleziona la strategia in base ai pattern di aggiornamento e al partizionamento della tabella. Configurazioni dbt per BigQuery
Usa le stored procedure con parsimonia come strumenti di supporto, mai come sostituto del tracciamento di derivazione, dei test, delle code review e dei processi di rilascio.
Bronze: Conservare le Evidenze
Il layer Bronze non è “dati spazzatura”. Rappresenta il registro storico inoppugnabile di ciò che la piattaforma ha effettivamente ricevuto.
Per una tabella di eventi come offvia_bronze.raw_booking_events, conserva almeno:
raw_payload: il payload JSON originario o il record grezzoingested_at: un timestamp di ricezione affidabile assegnato dalla piattaformasource_system: identificativo del producer o del partnerevent_ido ID del messaggio, se disponibilemessage_published_at: timestamp di pubblicazione lato producerschema_version: versione del contratto di payload- campi di tracciamento come il message ID di Pub/Sub o un correlation ID
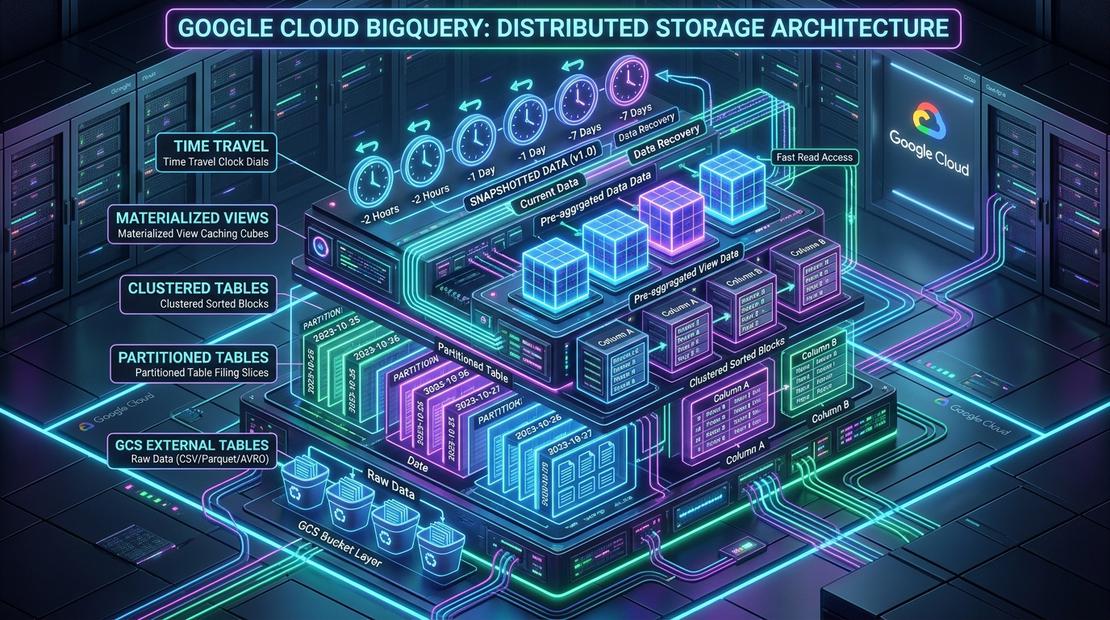
Partiziona il layer Bronze per data di ingestion e imposta una retention policy appropriata. Applica il clustering solo se i pattern di interrogazione lo giustificano. Non sovrascrivere mai i dati Bronze durante le normali trasformazioni: il loro scopo primario è la riproducibilità, il replay e l’auditabilità.
Silver: Rendere i Dati Affidabili e Riutilizzabili
I modelli Silver convertono payload opachi in record tipizzati. È qui che:
- Estrai i campi dal JSON.
- Applichi
SAFE_CASTe funzioni di parsing sicure per input non fidati. - Normalizzi codici valuta, stati, codici aeroportuali e fusi orari.
- Deduplichi le consegne multiple.
- Separi i record che non rispettano il contratto conformato.
- Preservi i metadati operativi come
ingested_at, sorgente e gli ID evento originali.
Due Timestamp per Rispondere a Due Domande Diverse
event_timestamp risponde a: Quando si è verificato l’evento di business?
ingested_at risponde a: Quando la nostra piattaforma ha ricevuto questo record?
Per l’estrazione incrementale, prediligi un timestamp di arrivo o di modifica affidabile come ingested_at; altrimenti, un evento arrivato in ritardo rischia di andare perso per sempre. Per la reportistica di business, il partizionamento e l’analisi storica, usa la data dell’evento di business coerente con la granularità attesa.
Questo non significa filtrare ciecamente con ingested_at > MAX(ingested_at) all’infinito. Questo pattern con watermark rigido fallisce quando arrivano eventi tardivi, un’esecuzione si interrompe parzialmente, i timestamp collidono o le rettifiche aggiornano date di business storiche. Le pipeline di produzione necessitano di una finestra di sovrapposizione (lookback window) e di strategie idempotenti di merge o di ricostruzione delle partizioni.
Un Pattern Incrementale Più Sicuro in Dataform
Il modello seguente implementa un lookback di tre giorni sull’ingestion. Rilegge una finestra delimitata del Bronze, seleziona la versione consegnata più recente per ciascun booking_id e consente a Dataform di eseguire il merge tramite la chiave uniqueKey dichiarata. La finestra di lookback consente il recupero di retry e arrivi posticipati; la deduplicazione rende sicura la rielaborazione.
-- definitions/silver/stg_bookings.sqlx
config {
  type: "incremental",
  schema: "offvia_silver",
  name: "stg_bookings",
  uniqueKey: ["booking_id"],
  bigquery: {
    partitionBy: "DATE(booking_timestamp)",
    clusterBy: ["origin_airport", "destination_airport"]
  },
  assertions: {
    uniqueKey: ["booking_id"],
    nonNull: ["booking_id", "passenger_id", "flight_id", "booking_timestamp"],
    rowConditions: [
      "total_amount >= 0",
      "currency IN ('EUR', 'USD', 'GBP')"
    ]
  }
}

WITH source_rows AS (
  SELECT
    JSON_VALUE(raw_payload, '$.booking_id') AS booking_id,
    JSON_VALUE(raw_payload, '$.passenger_id') AS passenger_id,
    JSON_VALUE(raw_payload, '$.flight_id') AS flight_id,
    SAFE_CAST(JSON_VALUE(raw_payload, '$.booking_timestamp') AS TIMESTAMP) AS booking_timestamp,
    SAFE_CAST(JSON_VALUE(raw_payload, '$.total_amount') AS NUMERIC) AS total_amount,
    JSON_VALUE(raw_payload, '$.currency') AS currency,
    JSON_VALUE(raw_payload, '$.booking_status') AS booking_status,
    JSON_VALUE(raw_payload, '$.origin_airport') AS origin_airport,
    JSON_VALUE(raw_payload, '$.destination_airport') AS destination_airport,
    ingested_at
  FROM ${ref("raw_bookings")}
  WHERE
    ${when(
      incremental(),
      "ingested_at >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 3 DAY)",
      "TRUE"
    )}
),

valid_candidates AS (
  SELECT *
  FROM source_rows
  WHERE booking_id IS NOT NULL
    AND booking_timestamp IS NOT NULL
),

deduplicated AS (
  SELECT * EXCEPT (row_number)
  FROM (
    SELECT
      *,
      ROW_NUMBER() OVER (
        PARTITION BY booking_id
        ORDER BY booking_timestamp DESC, ingested_at DESC
      ) AS row_number
    FROM valid_candidates
  )
  WHERE row_number = 1
)

SELECT *
FROM deduplicated
Dataform supporta nativamente le tabelle incrementali, applicando la logica incrementale dopo la prima compilazione completa. La documentazione ufficiale raccomanda di definire il sottoinsieme incrementale nella clausola WHERE condizionale del modello. Creare tabelle in Dataform
Avvertenze Fondamentali
Seleziona la riga vincente in modo consapevole. Ordinare per
booking_timestamp DESC, ingested_at DESCassume che il timestamp evento più recente rappresenti lo stato desiderato della prenotazione. Un approccio più robusto si basa su un numero di revisione immutabile, un numero di sequenza o una versione dell’evento generata dal producer.Conserva le righe scartate.
SAFE_CASTimpedisce il fallimento immediato della query, ma genera silenziosamenteNULL. Instrada i record malformati o non validi versooffvia_quarantine.invalid_booking_events, preservando il payload originario, i codici di errore eingested_at.Non confondere le asserzioni con la quarantena. Le asserzioni di Dataform individuano le righe non conformi e falliscono se la query restituisce record. Rappresentano eccellenti segnali di allarme e gate di rilascio, ma non dirottano autonomamente i record verso una tabella di quarantena. Costruisci il percorso di quarantena a monte nel modello SQL, quindi usa le asserzioni per garantire che i contratti Silver e Gold pubblicati siano privi di anomalie. Test di qualità dei dati in Dataform
Definisci una policy di severità per le asserzioni. Un’asserzione fallita non deve sempre bloccare indistintamente qualsiasi rilascio. Per metriche finanziarie critiche, blocca la pubblicazione o mantieni attiva la versione precedente verificata. Per anomalie secondarie, invia alert, metti in quarantena le righe anomale e mantieni consultabile l’ultima tabella valida. Questa è una decisione di SLA di business.
Modelli Incrementali: La Correttezza Prima dei Costi
Un modello incrementale è una strategia di manutenzione efficiente, non una bacchetta magica per le prestazioni.
Per un comando MERGE in BigQuery che aggiorna o cancella righe, il costo include i byte letti dall’operazione DML più la dimensione dei dati o delle partizioni di destinazione impattate. Sulle tabelle partizionate, circoscrivere le partizioni scansionate riduce drasticamente i costi computazionali. Comportamento dei prezzi DML in BigQuery
Potatura delle Partizioni (Partition Pruning) in un Merge
Quando la tabella di destinazione è partizionata per booking_date, circoscrivi l’intervallo bersaglio a quello che può effettivamente subire modifiche:
MERGE `project.offvia_silver.stg_bookings` AS T
USING `project.offvia_work.stg_bookings_delta` AS S
ON T.booking_id = S.booking_id
AND T.booking_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY)
WHEN MATCHED THEN
  UPDATE SET
    passenger_id = S.passenger_id,
    flight_id = S.flight_id,
    booking_timestamp = S.booking_timestamp,
    total_amount = S.total_amount,
    currency = S.currency,
    booking_status = S.booking_status,
    ingested_at = S.ingested_at
WHEN NOT MATCHED THEN
  INSERT (
    booking_id, passenger_id, flight_id, booking_timestamp,
    total_amount, currency, booking_status, ingested_at
  )
  VALUES (
    S.booking_id, S.passenger_id, S.flight_id, S.booking_timestamp,
    S.total_amount, S.currency, S.booking_status, S.ingested_at
  );
Questo approccio è corretto solo se la finestra di 7 giorni sulla destinazione coincide con la reale policy di correzione e arrivo tardivo dei dati. Non aggiungere un predicato di partizione solo per risparmiare sui costi se ciò causa duplicati o impedisce l’aggiornamento di correzioni storiche più vecchie. BigQuery supporta la potatura delle partizioni per MERGE quando la colonna di partizionamento viene filtrata in una condizione di ricerca o di unione applicabile. Aggiornare tabelle partizionate con DML
Per tabelle di fatti partizionate per data, valuta un pattern basato sulla ricostruzione delimitata delle partizioni anziché merge riga per riga: ricostruisci le partizioni recenti impattate usando insert_overwrite in dbt o una strategia equivalente di sostituzione atomica. Spesso questo si adatta meglio a log di eventi ad alta frequenza rispetto ad aggiornamenti continui su tabelle target molto estese.
I Dati Tardivi Devono Invalidare il Layer Gold
Un modello Silver può assorbire correttamente una prenotazione in ritardo, ma il layer Gold rimarrà disallineato se aggiorna unicamente la partizione del giorno corrente. La pipeline deve propagare l’elenco delle date di business impattate — ad esempio DATE(booking_timestamp) o flight_date — e ricostruire quelle specifiche partizioni nel Gold.
Una policy operativa resiliente include:
- Una normale finestra di lookback mobile, tipicamente tra 3 e 7 giorni.
- Una riconciliazione schedulata più ampia, ad esempio mensile, per coprire comportamenti noti delle sorgenti.
- Un percorso esplicito di backfill mirato per rettifiche storiche straordinarie.
- Un sistema di monitoraggio della freschezza dei dati che segnali mancate o ritardate consegne dalle sorgenti.
Controlli di Qualità per Proteggere la Reportistica
I controlli di qualità devono essere organizzati a livelli, sufficientemente leggeri da eseguire con frequenza e con un chiaro significato per il business.
| Livello | Esempi di Controllo | Azione in caso di Fallimento |
|---|---|---|
| Bronze | Volume sorgente inatteso, variazione di schema, percentuale anomala di JSON malformati | Notifica via alert; conserva i dati; verifica i contratti con i producer |
| Silver | ID non nulli, timestamp validi, valuta/stato ammessi, una sola versione canonica per chiave | Metti in quarantena le righe invalide; blocca i check critici sui contratti |
| Gold | Ricavi non negativi, numero di passeggeri non superiore alla capienza, copertura continua delle date | Blocca o annulla la pubblicazione del data mart impattato; allerta il data owner |
Esempio: Asserzione sulla Capienza dei Voli
-- definitions/assertions/assert_route_capacity.sqlx
config {
  type: "assertion",
  schema: "offvia_quality"
}

SELECT
  flight_date,
  flight_id,
  total_passengers_booked,
  seat_capacity
FROM ${ref("fct_daily_route_profitability")}
WHERE total_passengers_booked > seat_capacity
Un’asserzione in Dataform è una query che deve restituire zero righe; qualsiasi riga restituita costituisce un fallimento del test. Le asserzioni possono essere dichiarate nella configurazione del modello oppure create come file SQLX dedicati. Test di qualità dei dati in Dataform
Evita costosi test che scansionano l’intera cronologia a ogni esecuzione oraria. Circoscrivi i controlli alle sole partizioni modificate e pianifica riconciliazioni complete a intervalli compatibili con il budget e la tolleranza al rischio.
Gold: Modellare i Dati per i Consumatori di Business
Il layer Gold non è semplicemente un’altra tabella ripulita. È un vero e proprio prodotto dati dotato di granularità (grain) dichiarata, ownership, contratto di qualità e requisiti di performance.
Per Offvia, un data mart sulla redditività delle rotte può avere come granularità una riga per volo oppure una riga per rotta al giorno. Non mescolare mai le due dimensioni nello stesso modello. Il modello sottostante adotta la granularità di una riga per volo poiché raggruppa per flight_id; trattalo come data mart sulle prestazioni dei voli e aggrega separatamente se la dashboard richiede il livello rotta/giorno.
-- definitions/gold/fct_flight_performance.sqlx
config {
  type: "table",
  schema: "offvia_gold",
  name: "fct_flight_performance",
  bigquery: {
    partitionBy: "flight_date",
    clusterBy: ["carrier_code", "origin_airport", "destination_airport"]
  },
  tags: ["gold_marts", "executive_reporting"]
}

WITH flight_bookings AS (
  SELECT
    DATE(f.departure_scheduled_time) AS flight_date,
    f.flight_id,
    f.carrier_code,
    f.flight_number,
    f.origin_airport,
    f.destination_airport,
    f.aircraft_model,
    f.seat_capacity,
    COUNT(DISTINCT b.booking_id) AS total_passengers_booked,
    COALESCE(SUM(b.total_amount), 0) AS total_gross_revenue,
    COALESCE(AVG(b.total_amount), 0) AS average_ticket_price
  FROM ${ref("stg_flights")} AS f
  LEFT JOIN ${ref("stg_bookings")} AS b
    ON f.flight_id = b.flight_id
   AND b.booking_status IN ("CONFIRMED", "CHECKED_IN")
  GROUP BY 1, 2, 3, 4, 5, 6, 7, 8
)

SELECT
  flight_date,
  flight_id,
  carrier_code,
  flight_number,
  origin_airport,
  destination_airport,
  aircraft_model,
  seat_capacity,
  total_passengers_booked,
  ROUND(SAFE_DIVIDE(total_passengers_booked, seat_capacity) * 100, 2) AS seat_occupancy_percentage,
  total_gross_revenue,
  average_ticket_price,
  CASE
    WHEN SAFE_DIVIDE(total_passengers_booked, seat_capacity) >= 0.85 THEN "HIGH_PROFIT"
    WHEN SAFE_DIVIDE(total_passengers_booked, seat_capacity) >= 0.60 THEN "BREAK_EVEN"
    ELSE "UNDERPERFORMING"
  END AS route_performance_tier,
  CURRENT_TIMESTAMP() AS transformed_at
FROM flight_bookings
Schema a Stella o Tabella Unica Denormalizzata (One Big Table)?
| Pattern | Punti di Forza | Compromessi | Quando Utilizzarlo |
|---|---|---|---|
| Schema a Stella (Star Schema) | Dimensioni riutilizzabili, modellazione storica pulita, minore ridondanza | I consumatori devono gestire join; richiede governance semantica | Molti domini condividono le medesime dimensioni o le Slowly Changing Dimension (SCD) sono critiche |
| One Big Table (OBT) | Consumo immediato in BI, zero join a runtime, query veloci e prevedibili sulle dashboard | Duplica attributi; rende backfill e correzioni dimensionali più pesanti | Una dashboard specifica o un’attività esplorativa richiede un contratto denormalizzato e stabile |
BigQuery gestisce egregiamente entrambi i pattern. Un compromesso collaudato consiste nel mantenere dimensioni e fatti conformati nei layer Silver/Gold, pubblicando tabelle denormalizzate ad hoc solo dove la latenza, la semplicità d’uso per gli analisti o la concorrenza delle dashboard lo rendono conveniente.
Checklist di Produzione
Prima di considerare pronto per la produzione il layer di trasformazione, verifica i seguenti punti:
- Il layer Bronze è immutabile, riproducibile e include i metadati di ingestion.
- Ogni entità Silver possiede una chiave univoca, una granularità definita, una regola di deduplicazione e una politica per gli arrivi tardivi.
- I record scartati confluiscono in un dataset di quarantena interrogabile, corredati di codici di errore e dettagli.
- I modelli incrementali adottano una finestra di sovrapposizione (lookback) e sono strettamente idempotenti.
- Le istruzioni
MERGEo le sostituzioni di partizione scansionano unicamente le partizioni suscettibili di modifiche. - Gli eventi arrivati in ritardo innescano il ricarico delle corrispondenti partizioni temporali di business nel layer Gold.
- Le tabelle Gold dichiarano esplicitamente la loro granularità nella documentazione e garantiscono le regole di business.
- Il fallimento di asserzioni critiche impedisce la pubblicazione di dati errati nella reportistica aziendale.
- SQL, test, pianificazioni, permessi e configurazioni di deployment sono versionati su Git e soggetti a review.
- Le dashboard interrogano tabelle Gold o modelli semantici governati, mai le tabelle grezze Bronze.
- Costi, freschezza, volumi, fallimenti di asserzioni e tassi di quarantena sono costantemente monitorati.
Conclusioni e Prossimi Passi
Il layer di trasformazione è il punto nevralgico in cui una semplice infrastruttura di ingestion diventa una piattaforma dati solida e affidabile.
Le anomalie riscontrate da Offvia (ricavi negativi e posti passeggeri impossibili) non derivavano da banali errori di sintassi SQL, ma da carenze contrattuali: retry grezzi considerati come nuove prenotazioni, valori malformati ammessi nel calcolo dei ricavi e una stored procedure monolitica priva di test e confini di sicurezza.
Un’architettura Medallion rende questi confini rigorosi. Bronze conserva le evidenze. Silver genera entità riutilizzabili e pulite. Gold pubblica contratti di business affidabili. Dataform o dbt trasformano i modelli SQL in un flusso di lavoro versionato, tracciato e basato su dipendenze esplicite, lasciando a BigQuery la potenza del calcolo distribuito.
Nella Parte 6 metteremo in pratica queste fondamenta: creeremo un repository Dataform, configureremo i modelli SQLX da Bronze a Gold, implementeremo le asserzioni e la quarantena automatizzata, e ottimizzeremo l’esecuzione con un flusso di rilascio pronto per la produzione.
Riferimenti Ufficiali
- Panoramica e architettura di Dataform
- Creare tabelle e tabelle incrementali in Dataform
- Test di qualità dei dati con asserzioni Dataform
- Sintassi BigQuery
MERGE - Aggiornare tabelle partizionate BigQuery con DML
- Configurazione dell’adapter BigQuery per dbt
- Configurazioni BigQuery per dbt
- Configurare modelli incrementali in dbt
Community Discussion 0